FAQ 리치 결과가 끝난 뒤의 구조화 데이터: GEO용으로 무엇을 남겼나
GEO(생성형 검색 최적화)용 특별 마크업은 없습니다. FAQPage JSON-LD는 그대로 두고, 시간은 화면의 Q&A와 날짜가 붙은 측정값 본문에 씁니다.
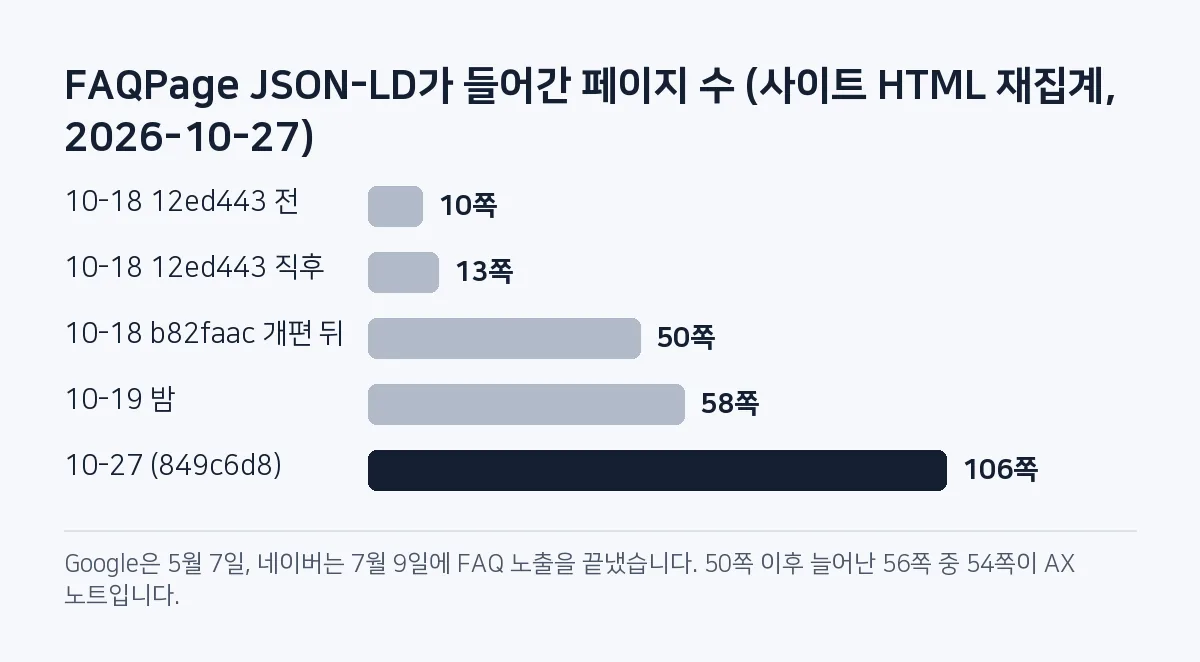
이 사이트 HTML 173개 가운데 106개에 FAQPage JSON-LD가 들어 있고, 질문은 374개입니다. 2026년 10월 27일 HEAD(849c6d8)에서 센 값이고, 이 마크업으로 생기는 Google 리치 결과는 0입니다. Google은 5월 7일, 네이버는 7월 9일에 FAQ 노출을 끝냈습니다. 그런데 이 사이트에서 FAQ JSON-LD를 손으로 쓴 페이지까지 넓힌 커밋(12ed443)은 10월 18일에 "SEO/GEO pass"라는 이름으로 들어갔습니다. 종료 공지보다 5개월 늦은 작업이었고, 같은 날 리서치가 그 사실을 찾은 뒤 FAQPage는 남기고 더 손보지 않기로 정했습니다.
근거는 사이트 저장소의 git 기록(bdbbe97, 12ed443, 3f504be, b82faac), 10월 27일 HEAD(849c6d8)의 HTML 재집계, 10월 18일 작업 문서(리서치 01~06, 정보구조 명세, 적대적 리뷰 1), 검색 운영 기록, Google Search Central과 네이버 서치어드바이저 공지입니다. 외부 정책은 2026년 10월 27일에 원문을 다시 열어 확인했습니다.
목차 (9)
FAQPage 106쪽, 질문 374개, 리치 결과 0
배포되는 HTML의 application/ld+json 블록을 @type별로 센 결과입니다.
| 타입 | 페이지 수 | 2026-10 기준 검색 노출 |
|---|---|---|
| BreadcrumbList | 166 | Google은 데스크톱 이동 경로, 네이버는 사이트 정보 둘째 줄 |
| FAQPage | 106 | Google·네이버 모두 노출 종료 |
| Article | 84 | 리치 결과 없음, 날짜·저자 정보 |
| MobileApplication | 22 | 네이버 소프트웨어 요약 대상 |
| CollectionPage · ItemList | 22 · 16 | 목록 페이지 설명용 |
FAQPage 106쪽 가운데 60쪽이 AX 노트, 42쪽이 앱 소개와 도움말, 나머지 4쪽이 홈과 AX 허브입니다. 빌드 스크립트는 화면 Q&A와 같은 원본(노트·손 페이지는 <details><summary>, 생성 앱 페이지는 apps.json의 faq, 홈은 home_faq)에서 FAQPage를 만듭니다. 그래서 FAQ 2~4개를 두는 노트가 하나 늘 때마다 FAQPage도 하나 늘어납니다. 같은 방식으로 지난 커밋들을 다시 세면 10월 18일 오후 4시 9분 10쪽, 12ed443 직후 13쪽, 그날 밤 개편(b82faac) 뒤 50쪽, 10월 19일 밤 58쪽이었습니다. 13쪽에서 50쪽으로 늘어난 것은 명세를 구현한 b82faac에서였고, 그 50쪽 가운데 40쪽이 앱 소개·도움말 페이지였습니다(apps.json faq로 만든 생성 앱 페이지 8쪽, <details>가 있는 손 앱 페이지·도움말 32쪽). 50쪽 이후 늘어난 56쪽 가운데 54쪽은 AX 노트입니다.
FAQ JSON-LD를 넓힌 커밋은 Google 종료 5개월 뒤에 들어갔습니다
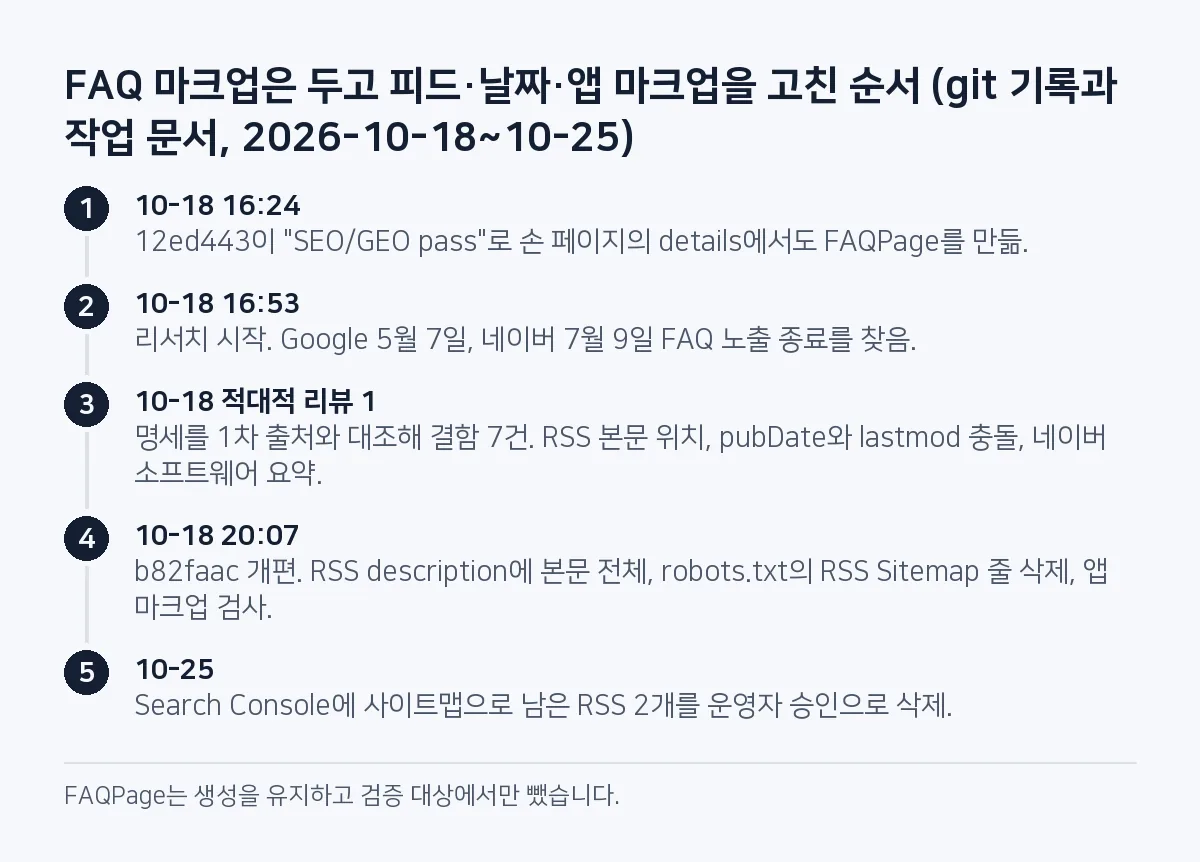
FAQPage는 10월 5일 사이트 개편(bdbbe97)에서 앱 페이지와 홈에 처음 들어갔습니다. 10월 18일 오후 4시 24분, 다른 에이전트 세션이 올린 12ed443의 제목은 "Site-wide SEO/GEO pass: FAQ JSON-LD, …"였고, 본문 첫 항목이 "FAQPage from <details> on hand pages"였습니다. FAQ 마크업을 검색과 AI 답변 노출을 돕는 장치로 보고 손으로 쓴 페이지까지 넓힌 커밋입니다.
Google Search Central 업데이트 목록에는 5월 8일자로 "This feature will no longer appear in Google Search starting May 7, 2026."이, 6월 15일자로 FAQ 리치 결과 문서를 지웠다는 항목이 있습니다. 그 전에도 2023년 9월부터는 잘 알려진 정부·보건 사이트에만 나오던 기능이었습니다. 네이버 서치어드바이저는 7월 8일 공지에서 웹 검색의 FAQ 노출을 7월 9일에 끝낸다고 알렸습니다.
29분 뒤인 오후 4시 53분에 Google·네이버·GEO 리서치를 병렬로 돌렸고, Google 리서치 문서 01이 FAQ 종료를 첫머리 결론 둘째 줄에 적었습니다. 12ed443에는 그 종료가 반영되지 않았습니다. Google의 생성형 AI 최적화 가이드(7월 10일 갱신)는 "Structured data isn't required for generative AI search, and there's no special schema.org markup you need to add."라고 적습니다.
지우지 않고, 검증하지 않고, 손대지 않기로 했습니다
같은 날 쓴 정보구조 명세는 FAQPage 행에 "현행 생성을 유지하되 늘리지 않고 Rich Results 검증 대상에서 뺀다"고 적었습니다. 적대적 리뷰 1은 생성 코드에 유지비가 들면 지우라고 권했지만, 명세는 그 부분을 받아들이지 않았습니다. 생성 코드가 이미 있고 함수 하나가 화면 Q&A의 원본을 읽어 JSON-LD를 쓰니 유지비가 0에 가깝다는 점, 네이버 종료 공지가 "남아있는 자주 묻는 질문(FAQ) 구조화 데이터 마크업은 웹 문서 분석 등에 보조적으로 활용될 수 있습니다"라고 하고 순위나 노출에는 영향이 없다고 한 점이 이유였습니다.
화면 Q&A와 같은 원본에서 만들기 때문에 마크업과 화면 내용이 같습니다. Google의 AI 기능 문서도 모범 사례로 "structured data matches the visible text on the page"를 꼽습니다.
FAQ를 늘려 리치 결과를 노리는 안은 두 검색엔진이 모두 노출을 끝낸 시점이라 처음부터 버렸습니다. Rich Results 검증을 게이트에 남기는 안도 Google이 문서를 지운 뒤라 검증할 기준이 없었습니다. 그런데 명세의 "늘리지 않는다"는 생성 방식 때문에 실제로는 "손대지 않는다"가 됐습니다. b82faac부터 앱·도움말 페이지 40쪽에 FAQPage가 붙었고, 그 뒤 노트마다 FAQ를 두는 규칙으로 106쪽이 됐습니다. 그동안 빌드의 FAQPage 생성 코드를 바꾼 커밋은 없습니다.
화면의 Q&A는 남깁니다. FAQ는 첫 문장에 답을 두는 규칙으로 쓰고, 그 문장은 JSON-LD가 없어도 본문으로 읽힙니다. 10월 25일에 한 노트의 FAQ 답에서 구호 같은 문장을 고쳤을 때(72a3ada) JSON-LD도 같은 문장으로 바뀌었습니다.
적대적 리뷰 1의 결함 7건 가운데 RSS 본문·날짜 신호·앱 마크업 세 건
10월 18일 적대적 리뷰 1은 명세의 SEO·GEO 주장을 Google 문서와 네이버 서치어드바이저 원문에 하나씩 맞춰 보고 반드시 고칠 결함 7건을 냈습니다. FAQ 종료 날짜, llms.txt를 Google이 무시한다는 입장 같은 큰 줄기는 맞았습니다.
첫째 결함은 RSS 본문 위치였는데, 명세는 본문 전체를 content:encoded에 넣고 <description>은 요약으로 두려 했습니다. 네이버 피드 제출 가이드의 예제에는 <description>만 있고, 주의사항은 "각 item의 본문은 일부가 아닌 모든 내용(본문 전체 공개)이 포함될 수 있도록" 하라고 합니다. content:encoded는 가이드에 나오지 않습니다. 지금 ko 피드의 item 56개는 <description>에 본문 HTML을 담고 있고, 그 HTML 길이의 중앙값은 약 1만 자입니다.
둘째는 날짜 신호 충돌이었습니다. Google은 RSS도 사이트맵으로 받고, 2014년 10월 Google 블로그는 "XML sitemap uses <lastmod> RSS uses <pubDate>"라고 적습니다. 명세처럼 pubDate를 발행일로 두고 RSS를 Google에 내면, 같은 URL에 사이트맵은 수정일을, RSS는 발행일을 수정 시각으로 보냅니다. 리뷰는 이 근거를 블로그 본문을 열지 못해 "추정"으로 적었는데, 이번에 원문을 열어 보니 맞았습니다. 해결은 Google에는 수정일을 담은 sitemap.xml만 내는 것이었습니다. 수정일을 본문 해시로 정하는 방법은 사이트맵 lastmod가 전부 같은 날짜였다: 본문 해시로 수정일 정하기에 있습니다. 오후 4시 20분 커밋(3f504be)이 robots.txt에 넣은 RSS Sitemap: 줄은 그날 밤 개편에서 빠졌습니다.
셋째는 명세의 "받을 수 있는 리치 결과는 Breadcrumb와 사이트 이름뿐"이라는 결론이었습니다. 네이버는 10월 15일 공지에서 HowTo 노출을 끝내면서, 소프트웨어 schema 항목은 본문 아래 요약으로 보여 준다고 했습니다(이 사이트 앱 페이지의 실제 노출은 확인하지 못했습니다). 그래서 MobileApplication에 name, applicationCategory, operatingSystem, 절대 URL, 너비·높이가 있는 스크린샷, 160자 이하 설명을 요구하는 검사가 빌드 게이트에 들어갔습니다. 게이트가 어떻게 커밋을 막는지는 여러 에이전트 세션이 고치는 정적 사이트: 커밋 전 --check 게이트 하나에 적었습니다.
RSS를 사이트맵으로 내지 않는다는 결정은 Search Console 화면에서 다시 깨졌습니다
코드에서는 결정이 지켜졌습니다. robots.txt의 Sitemap: 줄은 지금도 sitemap.xml 하나뿐입니다. 저장소 작업 지침에도 "never submit RSS as a sitemap"이 적혀 있습니다. 그런데 10월 22일 Search Console에 rss.xml과 en/rss.xml이 사이트맵으로 제출됐습니다. 10월 25일 오후 2시대에는 에이전트가 이 둘과 sitemap.xml, 모두 세 개를 API로 다시 제출했습니다. 세 시간쯤 뒤 사이트맵 구조를 손보던 회차에서 에이전트가 지침과 어긋난 것을 발견했고, 운영자 승인을 받아 RSS 두 개를 목록에서 지웠습니다. 빌드 게이트는 저장소 안의 파일만 보기 때문에 Search Console 설정은 검사하지 못했습니다.
노출 12회, 클릭 0회인 사이트에서는 효과를 잴 수 없었습니다
이 글의 판단은 Google과 네이버 문서를 근거로 한 것이고, 측정값으로 확인한 것이 아닙니다. Search Console 실적은 9월 29일부터 10월 26일까지 노출 12회, 클릭 0회였고, 10월 27일 전수 검사에서 색인된 페이지는 44개였습니다. 화면의 FAQ가 AI 답변에 인용되는지, 네이버가 남은 FAQ 마크업을 실제로 분석에 쓰는지는 이 숫자로 알 수 없습니다. Bing이나 ChatGPT 검색이 FAQPage를 읽는지도 확인하지 않았습니다.
2023년 9월 이후에도 FAQ가 나오던 정부·보건 권위 사이트라면 5월 7일 이전의 실제 노출 기록이 있을 테니, 이 판단을 그대로 옮기지 말고 자기 Search Console 기록부터 보십시오.
자동 생성 쪽에도 고칠 곳이 하나 있습니다. 빌드가 HTML 태그를 공백으로 바꿔 텍스트를 뽑아서, 링크가 끝나는 자리에 공백이 하나 더 들어갑니다. 한 노트의 FAQ JSON-LD에는 화면의 "여는 법에" 대신 "여는 법 에"가 들어가 있습니다(10월 26일 운영 기록에서 처음 확인).
타입별로 세고, 종료 공지를 원문으로 열고, RSS가 사이트맵 목록에 없는지 봅니다
- 배포 결과물의 HTML에서 JSON-LD 타입별 페이지 수를 셉니다.
@graph안의 노드와 배열 타입(["MobileApplication","VideoGame"])도 풀어서 셉니다. - 센 타입마다 Google Search Central 업데이트 목록과 네이버 서치어드바이저 공지를 검색해 종료·제한 날짜를 확인합니다. 리서치 문서가 적은 날짜도 원문으로 한 번 더 엽니다.
- 종료된 타입은 지우기 전에 생성 방식을 봅니다. 화면 텍스트에서 자동으로 만들어지면 그대로 두고 검증 목록에서만 뺍니다. 손으로 쓴 JSON-LD라면 지우는 쪽이 낫습니다.
- RSS는 item의
<description>에 본문 전체를 넣고,pubDate는 발행일로 둡니다. Google에는 sitemap.xml만 냅니다. - 앱 페이지가 있으면 SoftwareApplication 계열 마크업의 필수 항목과 스크린샷 크기를 빌드 검사로 묶습니다.
- Search Console 사이트맵 목록을 열어 RSS가 들어가 있지 않은지 봅니다. 저장소 검사로는 잡히지 않는 경로입니다.
1번은 이 스크립트로 했습니다.
import json, os, re, sys, collections
pages, questions = collections.Counter(), 0
for d, _, fs in os.walk(sys.argv[1]):
    for f in fs:
        if not f.endswith(".html"): continue
        s = open(os.path.join(d, f), encoding="utf-8").read()
        seen = set()
        for m in re.finditer(r'<script type="application/ld\+json">(.*?)</script>', s, re.S):
            data = json.loads(m.group(1))
            nodes = data if isinstance(data, list) else data.get("@graph", [data])
            for node in nodes:
                t = node.get("@type")
                seen.update(t if isinstance(t, list) else [t])
                if t == "FAQPage": questions += len(node.get("mainEntity", []))
        pages.update(seen)
print(pages.most_common(), "FAQ questions:", questions)
FAQ 마크업에 시간을 더 쓰지 마십시오. 같은 시간이면 본문에 날짜와 직접 잰 숫자를 하나 더 넣는 편이 낫습니다.
남은 일
FAQ JSON-LD 텍스트를 뽑을 때 링크 끝에 생기는 공백을 고칩니다. 노출이 쌓여 페이지별 비교가 가능해지면, FAQ가 있는 노트와 없는 페이지의 검색 실적을 나눠서 다시 봅니다.
자주 묻는 질문
FAQPage 구조화 데이터는 2026년에도 Google 검색에 표시되나요?
표시되지 않습니다. Google은 2026년 5월 7일부터 FAQ 리치 결과를 검색에 보여 주지 않고, 6월 15일에 해당 문서를 지웠습니다. 네이버도 2026년 7월 9일에 웹 검색의 FAQ 노출을 끝냈습니다.
FAQPage JSON-LD를 지워야 하나요?
화면의 Q&A에서 자동으로 만들어진다면 지울 이득이 거의 없습니다. 네이버는 남은 FAQ 마크업이 순위에 영향이 없고 문서 분석에 보조로 쓰일 수 있다고 했습니다. 손으로 따로 관리하는 마크업이라면 화면과 어긋날 위험이 있으니 지우는 편을 권합니다.
GEO를 위해 따로 넣어야 하는 schema가 있나요?
Google 기준으로는 없습니다. Google의 생성형 AI 최적화 가이드는 구조화 데이터가 생성형 AI 검색에 필요하지 않고 따로 넣을 schema.org 마크업도 없다고 적습니다. llms.txt도 Google 검색은 무시한다고 밝혔습니다.
이 글은 SugarMount가 직접 측정한 값으로 쓰고, 초안 작성에 AI 코딩 에이전트를 썼습니다.
다른 AX 노트
- 여러 에이전트 세션이 고치는 정적 사이트: 커밋 전 --check 게이트 하나
- 개인정보처리방침 AI 처리 위치(국외 이전): 하루에 두 번 고친 고지를 코드에 묶기
- 사이트맵 lastmod가 전부 같은 날짜였다: 본문 해시로 수정일 정하기
- Android assets를 미리 gzip한 실측: APK 이득은 0, .pack.gz는 .pack이 되어 FileNotFoundException
- SKT 판매 삼성 폰에서 market://을 열면 스토어 선택 창이 뜬다: Play 패키지부터 지정하기
- addOnCompleteListener(this)가 onStop에서 지운 리스너 때문에 스플래시에 멈춘 버그