테스트 3,066개가 초록인데 DB를 못 여는 코드가 숨어 있었다: 가드 지워 보기
통과한 테스트 개수는 증거가 아닙니다. 지키는 코드를 지웠을 때 빨개지는 테스트만 테스트로 셉니다.
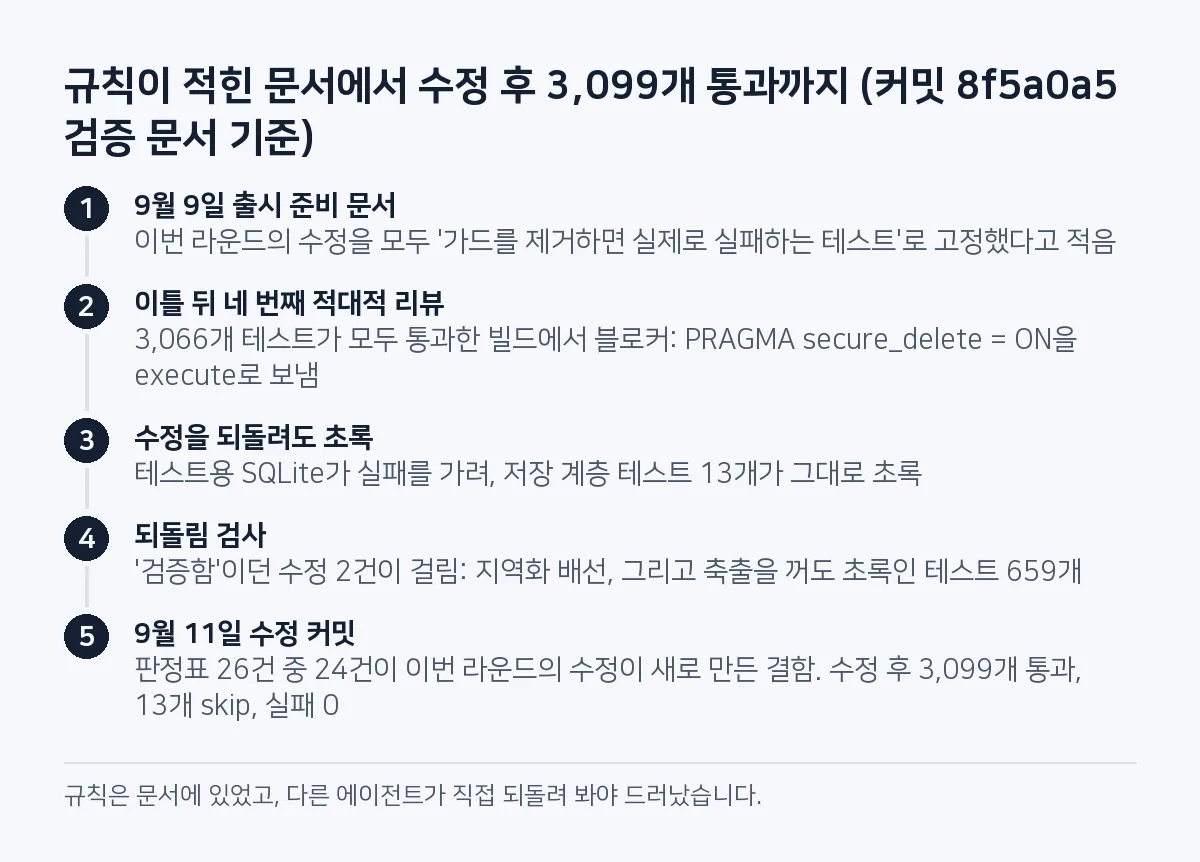
3,066개 테스트가 모두 통과한 빌드에서 블로커가 나왔습니다. P2P 채팅 앱(Flutter)의 네 번째 적대적 리뷰가 찾았고, 수정 커밋은 2026년 9월 11일에 들어갔습니다. 새로 넣은 SQLite 설정 한 줄이 소스를 따라가 보면 기기에서 데이터베이스 열기를 실패시키는데, 테스트용 SQLite가 이 실패를 완전히 가려서, 수정을 되돌려도 저장 계층 테스트 13개는 그대로 초록이었습니다. 이 앱에는 "가드를 지우면 실패하는 테스트"라는 규칙이 이미 있었는데도, 같은 리뷰에서 검증했다던 수정 2건이 이 검사에 걸렸습니다. 한글뷰어 슈가독은 같은 검사를 Python 스크립트 12개, 변이 행 970개로 적어 두고 출시 때 돌립니다.
근거는 P2P 채팅 앱 저장소의 커밋 8f5a0a5 본문과 같은 커밋의 검증 문서, 한글뷰어 슈가독 저장소의 scripts/qa 스크립트와 1.2.0·1.3.0 출시 기록입니다. 숫자는 2026년 10월 20일에 git 기록에서 다시 확인했습니다.
목차 (8)
행을 돌려주는 PRAGMA를 execute로 보냈다
블로커는 PRAGMA secure_delete = ON 한 줄이었습니다. 지운 메시지 자리를 0으로 덮으려고 이번 라운드에 넣은 설정인데, 코드는 이 줄을 결과 행을 받지 않는 db.execute()로 보냈습니다. 문제는 이 pragma가 행을 하나 돌려준다는 점입니다. 같은 함수 안의 pragma 다섯 개를 2026년 10월 20일 Python sqlite3(SQLite 3.45.1, 메모리 DB)로 다시 돌려 봤습니다.
| pragma | 돌려준 행 | 수정 전 호출 |
|---|---|---|
secure_delete = ON | [(1,)] | execute (위반) |
foreign_keys = ON | [] | execute |
synchronous = NORMAL | [] | execute |
journal_mode = WAL | [('memory',)] | rawQuery |
wal_autocheckpoint = 0 | [(0,)] | rawQuery |
이 표에서 행을 돌려주는 다른 pragma 두 개는 처음부터 rawQuery를 썼고, 새 줄만 아니었습니다. 이 설정은 데이터베이스를 열 때마다 버전 확인보다 먼저 돕니다. 리뷰 문서는 iOS 쪽 실패 경로를 플러그인 소스로 끝까지 따라갔습니다. execute 경로가 SQLITE_ROW를 받으면 실패로 처리하고, 그러면 openDatabase 자체가 실패해 저장 계층 전체를 쓸 수 없게 됩니다. Android 쪽은 SQLiteDatabase.execSQL이 행을 돌려주는 문장을 받지 않는다는 API 계약에서 끌어낸 판단입니다. 두 플랫폼 모두 기기에서 실제 예외를 본 것은 아닙니다.
수정은 한 단어였습니다.
- await db.execute('PRAGMA secure_delete = ON');
+ await db.rawQuery('PRAGMA secure_delete = ON');
테스트용 SQLite는 이 실패를 볼 수 없었다
단위 테스트는 실기기의 SQLite가 아니라 데스크톱용 sqflite_common_ffi 위에서 돕니다. 이 백엔드의 execute는 인자가 없으면 문장을 실행하고 나온 행을 그냥 버립니다. 예외가 나지 않으니, 3,066개 테스트는 이 결함에 대해 처음부터 아무것도 말할 수 없었습니다.
동작을 재현하는 테스트로는 잡을 수 없어서, 가드는 소스를 읽는 방식으로 만들었습니다. pragma_execute_guard_test.dart는 lib/ 전체에서 .execute(에 넘긴 문자열을 뽑고, PRAGMA로 시작하는 것은 실제 SQLite에 rawQuery로 돌려 행이 나오는지 봅니다. ffi 백엔드도 rawQuery에서는 행을 그대로 돌려주므로 이 검사는 테스트 환경에서도 사실을 말합니다. 그때 lib/의 execute 호출은 14건이었고, PRAGMA 3건과 테이블·인덱스를 만드는 문장 11건이었습니다.
스캐너에는 자기검사도 넣었습니다. 찾은 execute 문자열이 5건보다 적으면 정규식이 깨진 것으로 보고 실패합니다. (pragma 목록도 손으로 적지 않고 SQLite에 직접 물어보게 했습니다.)
검증 끝이라던 수정 2건의 가드가 아무것도 막지 않았다
같은 리뷰는 되돌림 검사도 돌렸습니다. 수정을 하나씩 되돌려 그 수정을 지킨다던 테스트가 빨개지는지 봅니다. 직전 라운드에 AI 코딩 에이전트가 "검증함"으로 보고한 수정 가운데 2건이 이 검사에서 걸렸습니다.
- 접근성 문구를 한국어로 읽게 하는 지역화 배선을 앱에서 통째로 지워도 테스트가 초록이었습니다. 테스트가 띄운 것은 테스트 하니스의
MaterialApp이었고, 실제 앱 화면은 한 번도 띄우지 않았기 때문입니다. 지금은 실제 앱 화면을 띄우고, 그 아래에서 해석된 지역화 값을 확인합니다. - 메시지 축출 가드는 전부 CI가 설정하지 않는 환경 변수 뒤에 있었고, 축출을 꺼도 그 변수 없이 도는 테스트 659개가 모두 초록이었습니다. 지금은 기본 실행에 들어가 있고, 그 영역의 되돌림은 모두 빨개집니다.
리뷰 판정표에는 26건이 올라갔고, 그중 24건이 이번 라운드의 수정이 새로 만든 결함이었습니다. "직전 수정이 새 결함을 만들었다"는 패턴의 네 번째 반복이었습니다. 에이전트가 틀린 곳은 코드보다 보고였습니다. 테스트를 추가했고 통과했다는 말은 사실이었지만, 그 테스트가 무엇을 재는지는 확인하지 않았습니다.
리뷰도 에이전트가 했습니다. 다만 리뷰어는 코드를 한 줄도 고치지 않았고, 되돌림 실험은 끝날 때마다 원래대로 돌려놓았습니다. 리뷰 지시서의 판정 규칙에는 이런 줄이 있었습니다. "되돌렸는데 테스트가 통과하면 그건 테스트가 틀린 것이다." 수정을 마친 뒤 결과는 3,099개 통과, 13개 skip, 실패 0이었습니다.
규칙은 이틀 전부터 문서에 있었다
에이전트가 테스트를 추가했다고 보고하면, 그 테스트가 지킨다는 코드를 지우고 다시 돌려 보십시오. 빨개지지 않는 테스트는 개수에 넣지 않습니다. 이 앱의 지침 파일은 "완료"에 세 조건을 겁니다. 정적 분석 에러 0, main.dart에서 닿는 코드, 테스트로 지켜지는 코드입니다. 9월 9일 출시 준비 문서에는 이번 라운드의 수정을 모두 "가드를 제거하면 실제로 실패하는 테스트"로 고정했다고 적혀 있었지만, 이틀 뒤 다른 에이전트가 직접 되돌려 보자 2건이 걸렸습니다.
출시 전에 어떤 검사를 어떤 순서로 돌리는지는 AI가 만든 Android 앱, 출시 전에 무엇을 검사하나에 적었습니다.
가드 제거 하네스: 외부 패키지 없는 Python, 행 하나에 가드 하나
한글뷰어 슈가독은 2026년 10월 8일 첫 커밋부터 기능마다 가드 제거 스크립트를 함께 두었습니다. 10월 18일 기준으로 스크립트 12개, 변이 행 970개, 1,919줄입니다. 행 하나는 "이 파일의 이 문자열을 이렇게 바꾸면, 이 테스트 클래스가 실패해야 한다"는 약속입니다. 아래는 1.2.0 PDF 저장 스크립트의 실제 행 하나와 하네스 핵심부입니다.
# (id, 파일, [(원래 문자열, 바꿀 문자열)], 종류, 잡아야 할 테스트 클래스)
("ctl.logOnlySaved", P + "ReaderController.kt",
 [("if (result == PdfWriteResult.SAVED) log(...)", "log(...)")],
 "sugardoc", "ReaderControllerTest"),

for mid, rel, edits, kind, target in MUT:
    path, orig = mutate(rel, edits)          # 사본에서만 바꾼다
    try:
        ok, fails, out = run_row(kind, target)  # gradlew --no-daemon --tests *.target
        if "e: file://" in out:
            verdict = "COMPILE-ERROR"
        else:
            verdict = "FAILS-AS-EXPECTED" if ok else "STILL-PASSES"
    finally:
open(path, "w", encoding="utf-8").write(orig)(log(...)는 줄인 것이고, 실제 행에는 분석 이벤트 이름이 들어 있습니다.) 나머지 설계는 이렇습니다.
- 작업 트리에는 쓰지 않습니다. 저장소를
.git, 빌드 산출물, 서명 키를 빼고 별도 폴더로 복사해 거기서만 고칩니다. 같은 작업 트리에서 다른 에이전트 세션이 일하고 있을 수 있어서입니다. - 바꿀 문자열은 정확히 한 번 일치해야 합니다. 한 번이 아니면
BAD-PATTERN으로 표시합니다. 소스가 움직였으니 그 행을 고쳐야 합니다. - Gradle 종료 코드가 실패이고 JUnit 결과 XML에 실패한 케이스가 있어야
FAILS-AS-EXPECTED입니다. 종료 코드만 보면 오타 난 변이도 "잡았다"로 셉니다.
1.3.0에서 STILL-PASSES가 나온 2행
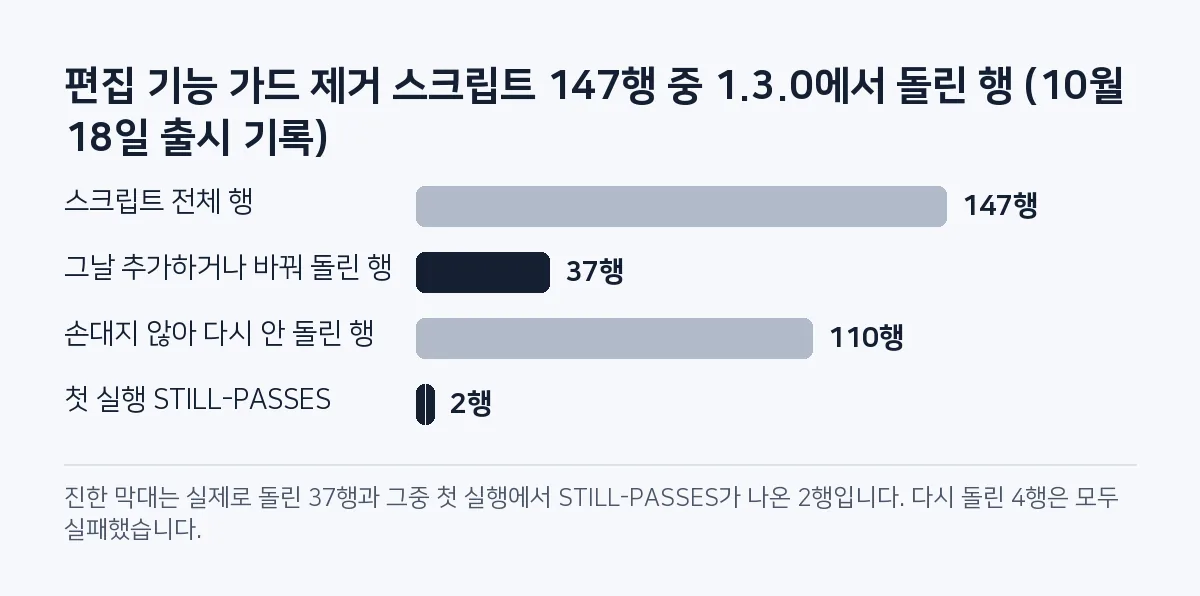
10월 18일 1.3.0 출시 기록에 실제 적발이 남아 있습니다. 편집 기능 스크립트의 147행이 모두 한 번씩 일치하는 것을 확인한 뒤, 그날 추가하거나 바꾼 37행을 돌렸습니다. 첫 실행에서 2행이 STILL-PASSES였습니다.
| 행 | 변이 | 원인 | 고친 것 |
|---|---|---|---|
retry.partialFails | 재저장 조건에서 partial || 삭제 | 테스트가 약했음 | 재생 중 두 번째 편집만 잃는 경우로 테스트를 강화 |
retry.cancelStops | 취소 확인 줄 삭제 | 같은 일을 하는 방어가 두 곳에 있었음 | 중복 방어를 지우고, 남은 실제 가드를 겨누도록 행을 바꿈 |
다시 돌린 4행은 모두 실패했습니다. 같은 날 PDF 저장 스크립트는 32행 전부 FAILS-AS-EXPECTED였습니다. STILL-PASSES가 늘 테스트가 약하다는 뜻은 아니더군요. 코드에 같은 방어가 두 겹 있으면 하나를 지워도 다른 하나가 막습니다. 그럴 때는 테스트는 두고 겹친 방어 코드를 정리합니다. (두 기능의 테스트도 에이전트가 썼습니다.)
남은 일
P2P 채팅 앱의 Android 쪽 실패는 아직 실측하지 않았습니다. 수정 전 커밋으로 APK를 만들어 에뮬레이터에서 처음 데이터베이스를 여는 순간의 logcat을 보는 일이 검증 문서에 남은 항목으로 적혀 있습니다. iOS는 확인할 macOS 환경이 없습니다. 한글뷰어 쪽은 1.3.0에서 편집 스크립트의 달라진 37행만 돌렸고, 손대지 않은 110행은 다시 돌리지 않았습니다. 오래된 행이 지금도 빨개지는지는 다음 전체 실행에서 확인할 겁니다.
자주 묻는 질문
가짜 테스트는 어떻게 찾나요?
테스트가 지킨다는 코드를 지우거나 뒤집은 뒤 그 테스트만 다시 돌립니다. 그래도 초록이면 그 테스트는 그 코드를 지키지 않습니다. SugarMount는 이 검사를 변이 행으로 적어 두고 출시 때마다 돌립니다.
AI가 만든 테스트를 믿어도 되나요?
통과한 개수만으로는 믿지 않습니다. P2P 채팅 앱에서는 테스트 3,066개가 통과한 상태로 블로커가 숨어 있었고, 검증했다던 수정 2건의 테스트는 수정을 지워도 초록이었습니다. 가드를 지웠을 때 빨개지는 것을 확인한 테스트만 셉니다.
뮤테이션 테스트 도구 대신 직접 스크립트를 쓴 이유는 무엇인가요?
알고 싶은 것이 "이 가드를 이 테스트가 지키는가"였기 때문입니다. 행마다 가드 하나와 그것을 잡아야 할 테스트 클래스 하나를 짝지어, 그 테스트만 돌립니다. 기성 도구와 속도나 적발률을 비교하지는 않았습니다.
이 글은 SugarMount가 직접 측정한 값으로 쓰고, 초안 작성에 AI 코딩 에이전트를 썼습니다.
다른 AX 노트
- LLM 공유 캐시에 프롬프트 인젝션이 굳을 수 있었다: 문맥을 보내지 않기로 한 블라인드 A/B
- AI 코딩 에이전트와 비밀값: 채팅·로그·권한 세 겹, 복사된 마스킹 정규식이 놓친 예외 2곳
- 'E2E 100% 통과'의 정체: expect()가 0개인 러너 7개를 지운 날
- 편집 기능을 만들고도 꺼서 출시했다: HWP 저장 검증 게이트가 잡은 누름틀 결함
- Android assets를 미리 gzip한 실측: APK 이득은 0, .pack.gz는 .pack이 되어 FileNotFoundException
- SKT 판매 삼성 폰에서 market://을 열면 스토어 선택 창이 뜬다: Play 패키지부터 지정하기